Verantwortungsvolle KI
Spricht deine KI deine Sprache?
Die meisten KI-Plattformen führen Dutzende unterstützter Sprachen auf.

Wie aim2balance.ai nach mehrsprachiger Leistung auswählt
aim2balance.ai Forschungsteam
März 2026
Sprachunterstützung ist mehr als ein Häkchen
Die meisten KI-Plattformen führen Dutzende unterstützter Sprachen auf. Belege dafür gibt es selten. Ein Modell kann im Training französischen Texten begegnet sein, ohne eine französische Anweisung zuverlässig zu befolgen, eine morphologisch komplexe polnische Frage richtig zu beantworten oder ein juristisches Problem auf brasilianischem Portugiesisch schlüssig zu durchdenken.
Bei aim2balance.ai kommen unsere Nutzerinnen und Nutzer aus der ganzen Welt und haben sprachlich vielfältige Hintergründe. Sie schreiben auf Französisch, Deutsch, Tschechisch, Italienisch, Arabisch, Chinesisch und in vielen weiteren Sprachen. Damit wir in all diesen Sprachen gleichbleibende Qualität liefern, müssen wir über englischsprachige Benchmark-Werte hinausgehen. In diesem Beitrag zeigen wir dir, wie wir auf derselben Pipeline, die unsere fünf Fähigkeitsrouten antreibt, eine mehrsprachige Evaluationsebene aufgebaut haben, was die Daten zeigen und welche Modelle sich dadurch einen Platz in der sprachbewussten Routing-Ebene verdient haben.
Sprach-Ranglisten sammeln
Dieselbe Pipeline, die Modelle auf den Fähigkeitsrouten bewertet, übernimmt die mehrsprachige Evaluation, mit einem strukturellen Unterschied: Statt Metriken nach Fähigkeits-Etikett zu aggregieren, aggregiert sie nach Sprach-Etikett.
Wie bei den Leistungs-Ranglisten werden die Werte normalisiert, nach der Qualität des Namensabgleichs nach Sicherheit gewichtet und pro Sprache und Modell gemittelt, sodass ein sauberes Leistungsprofil je Sprache entsteht.
Wir stützen uns auf neun spezialisierte mehrsprachige Ranglisten, die mehr als 21 Sprachen abdecken: Französisch, Italienisch, Portugiesisch, Spanisch, Katalanisch, Baskisch, Galicisch, Polnisch, Tschechisch und Chinesisch, um nur einige zu nennen. Zusammen liefern sie etwas, das allgemeine Fähigkeits-Benchmarks nicht können: eine direkte Messung, wie gut ein Modell abschneidet, wenn die Sprache wechselt. Dieselbe Aufgabe auf Französisch, Deutsch und Polnisch gestellt sollte vergleichbare Qualität ergeben, wenn das Modell diese Sprachen wirklich unterstützt.
Die drei Säulen mehrsprachiger Leistung
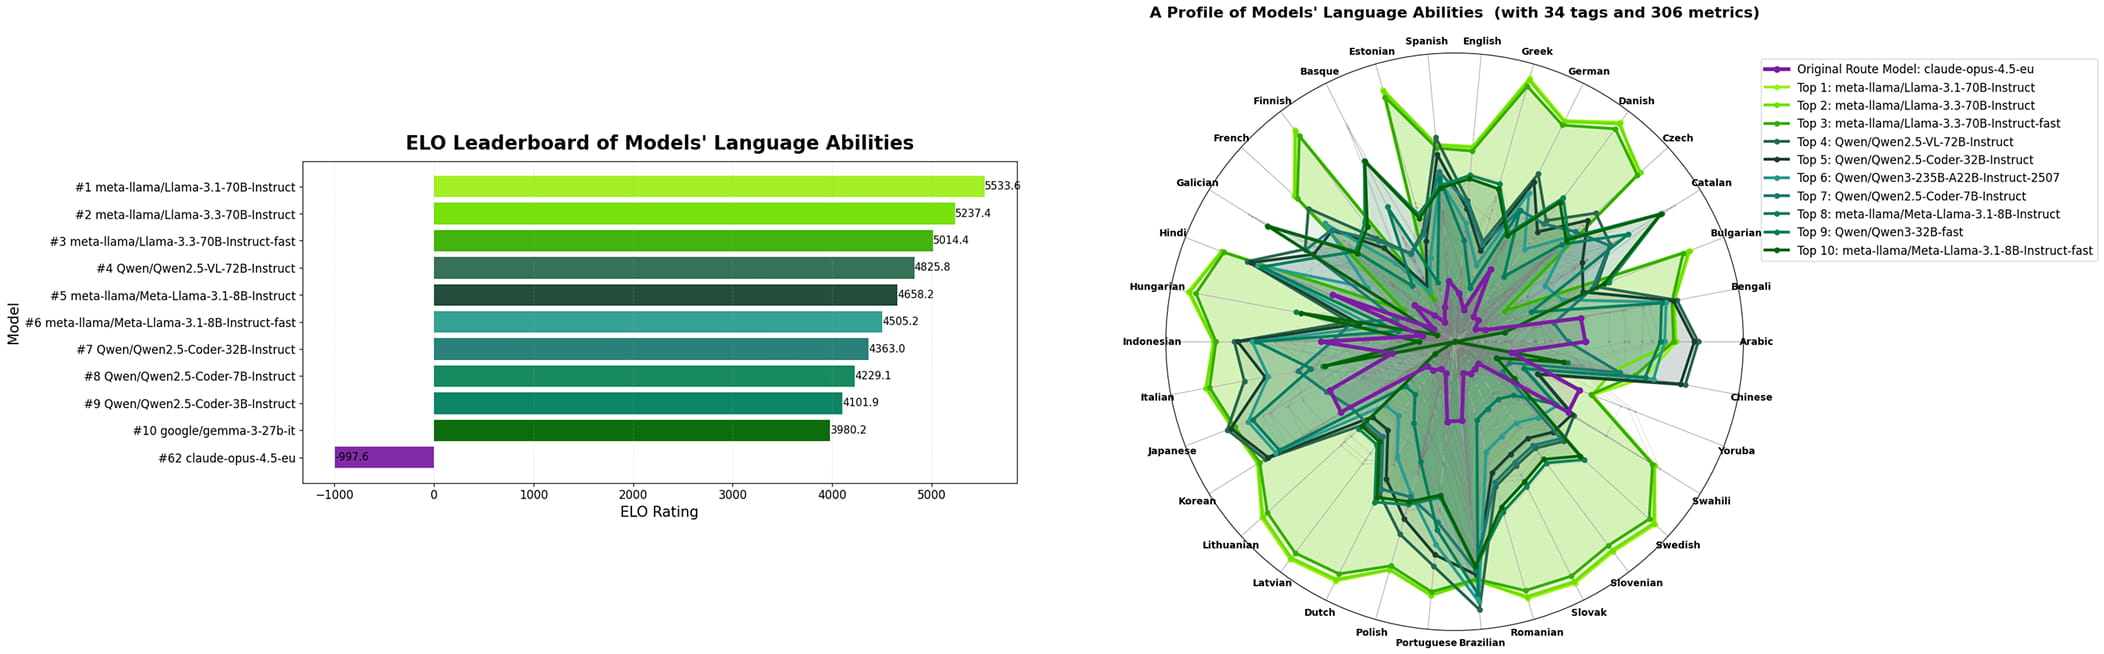
Abbildung 1: Links: Gesamtrangliste der mehrsprachigen ELO-Werte. Rechts: Radarprofil über einzelne Sprachachsen für die bestplatzierten Modelle.
Das Radar rechts in Abbildung 1 zeigt, welches Modell in welcher Sprache führt, und lässt drei unterschiedliche mehrsprachige Profile erkennen.
Llama-3.1-70B-Instruct zeichnet das breiteste und ausgewogenste Vieleck der Gruppe. Seine Leistung ist über die großen europäischen Sprachen wie Französisch, Deutsch, Spanisch und Italienisch durchweg stark und reicht zuverlässig auch ins Arabische und in ressourcenreiche Sprachen des Globalen Südens. Diese gleichmäßige Abdeckung spiegelt Metas anhaltende Investition in mehrsprachige Ausrichtung innerhalb der Llama-3.1-Generation wider und bestätigt seinen Status als das verlässlichste Allzweck-Rückgrat in unserem Katalog.
Qwen2.5-VL-72B-Instruct zeigt ein schmaleres europäisches Profil, aber außergewöhnliche Stärke in Chinesisch, Arabisch und mehreren nicht-westlichen Sprachen. Dieses Muster ergibt sich direkt aus Alibabas Trainingskorpus, das auf einem der reichhaltigsten chinesischsprachigen Datensätze beruht. Allgemeiner erreicht die Qwen-Familie eine starke mehrsprachige Verankerung in asiatischen Sprachen und Sprachen des Globalen Südens – eine Tiefe, die auch ihren Erfolg bei multimodalen und agentischen Aufgaben trägt. Dass sie in unserem Routing-System enthalten ist, stellt sicher, dass werkzeuggesteuerte und mehrsprachige Anfragen flüssig und im Kontext bedient werden.
Gemma-3-27B-it schlägt sich im europäischen Bereich trotz seiner geringeren Größe gut und hält robuste Leistung in Französisch, Deutsch, Spanisch und Italienisch. Seine leichtere Architektur macht es besonders wertvoll für Einsätze mit hohem Volumen oder knappen Ressourcen: Es bietet zuverlässige sprachliche Leistung, ohne ein Modell im Maßstab von 70B zu benötigen.
Diese Sprachprofile fließen direkt in das Modell-Routing von aim2balance.ai ein. Llama-Modelle verankern allgemeine und mehrsprachige Anfragen durch ihre konsistente Abdeckung der großen Sprachgruppen. Die Qwen-Familie, bekannt für ihre Stärke in Chinesisch, Arabisch und Sprachen des Globalen Südens, treibt die agentischen, kreativen und technischen Routen an, während Gemma-Modelle diese Stärken ergänzen und eine kompakte, aber leistungsfähige Option für wissenschaftliche Aufgaben bieten. Zusammen sorgt diese mehrsprachige Balance dafür, dass aim2balance.ai für jede Anfrage dynamisch das beste Modell auswählt und dabei in unterschiedlichsten sprachlichen Zusammenhängen hochwertige Ergebnisse liefert.


