Leistung
Wie wir für jede Aufgabe das richtige KI-Modell auswählen
Wenn du mit aim2balance.ai sprichst, siehst du ein einziges Chatfenster.

Ein Leistungsüberblick über den A2B-SmartRouter-Katalog
aim2balance.ai Forschungsteam
März 2026
Einleitung: Eine App, viele Modelle
Wenn du mit aim2balance.ai sprichst, siehst du ein einziges Chatfenster. Dahinter steht ein Katalog großer Sprachmodelle mit sehr unterschiedlichen Stärken und Kosten. Manche sind Spezialisten für Programmierung, manche glänzen beim kreativen Schreiben, manche sind stark im wissenschaftlichen Denken, und manche sind multimodale Agenten, die Diagramme und Dateien lesen können. Kein einzelnes System ist bei all diesen Aufgaben gleichzeitig das beste.
Der A2B-SmartRouter ist die Ebene, die für jede Anfrage entscheidet, welches Modell aufgerufen wird. Statt dich zwischen kryptischen Modellnamen wählen zu lassen, bieten wir fünf verständliche Routen an: General Chat, Creative Writing, Logic & Science, Deep Engineering und Agents & Tools. Der Router ordnet deine Anfrage einer dieser Routen zu und leitet sie an einen Modell-Cocktail weiter, der empirisch für diese Fähigkeit optimiert wurde.
In diesem Artikel analysieren und porträtieren wir alle Modelle in unserem Katalog und zeigen dir, wie wir den besten Modell-Cocktail hinter jeder Route unseres KI-Systems bestimmt haben.
Von öffentlichen Ranglisten zu Routen-Rankings
Der SmartRouter arbeitet mit fünf semantisch definierten Routen:
- General Chat für Alltagsfragen, Gespräche über gemischte Themen und sicheren, kohärenten Dialog.
- Creative Writing für Geschichten, Essays, Werbetexte und stilistische Umformulierungen.
- Logic & Science für Mathematik, MINT-Denken, akademische Erklärungen und Fragen aus Fachgebieten.
- Deep Engineering für Code-Erzeugung, Fehlersuche, Architektur und technische Spezifikationen.
- Agents & Tools für Werkzeug-Orchestrierung, Daten- und Diagrammanalyse, Dateiverständnis und multimodale Agentenaufgaben.
Für jede Route eine eigene Evaluation durchzuführen, wäre unverhältnismäßig teuer und ökologisch verschwenderisch. Stattdessen nutzen wir, was die Community bereits erarbeitet hat: öffentliche Benchmark-Ranglisten.
Bestehende Benchmarks sammeln und normalisieren
Wir haben 14 öffentliche Ranglisten zusammengetragen, die gemeinsam Schlussfolgern, Programmieren, Werkzeugnutzung, kreatives Schreiben und mehrsprachige Leistung abdecken. Jede Rangliste enthält Ergebnisse für sich überschneidende Teilmengen der 71 Modelle in unserem Katalog. Die Schwierigkeit: Sie unterscheiden sich in drei wichtigen Punkten:
- Unterschiedliche Metriken: Erfolgsquoten, Bewertungen durch Juroren, ELO-Zahlen und proprietäre Skalen.
- Unterschiedliche Benennungen: Dasselbe Modell taucht in verschiedenen Ranglisten unter verschiedenen Bezeichnungen auf.
- Unterschiedliche Aufgabenbereiche: Manche bewerten Code, manche Gespräche, manche spezialisierte Fachgebiete.
Das lösen wir in drei Schritten:
- Namensabgleich: Jeder Rohname eines Modells wird einer kanonischen Kennung in unserem Katalog zugeordnet. Wir vergeben einen Übereinstimmungswert in [0, 1] als Maß für die Sicherheit und führen ihn weiter mit.
- Metrik-Etiketten: Jede Benchmark-Metrik erhält eine oder mehrere Fähigkeits-Etiketten wie cap:logical_reasoning, cap:code_generation oder cap:creative_writing. Diese Etiketten werden dann einer oder mehreren Routen zugeordnet. Metriken zur Code-Erzeugung speisen zum Beispiel Deep Engineering, während Metriken zum kreativen Schreiben sowohl Creative Writing als auch General Chat speisen.
- Normalisierung und Gewichtung: Die Werte jeder Metrik werden per Min-Max auf [0, 1] normalisiert. Jeder Wert wird dann mit einer glatten Funktion seiner Namens-Übereinstimmung multipliziert, sodass gut zugeordnete Einträge stärker und unsichere Einträge weniger zählen.
Für jede Route fassen wir alle etikettierten, normalisierten und nach Sicherheit gewichteten Werte zu einer einzigen Stärkezahl pro Modell zusammen. Über diese Stärken lassen wir dann ein paarweises ELO-Turnier laufen, um ein stabiles Ranking zu erhalten: Modelle, die bei routenrelevanten Benchmarks immer wieder besser abschneiden als andere, steigen nach oben.
Fünf Routen, fünf Leistungsprofile
In den folgenden Abbildungen zeigt jede Route ein Radardiagramm mit den Fähigkeiten, die für sie am wichtigsten sind. Jede Achse ist eine Fähigkeitsdimension; je weiter ein Modell auf einer Achse reicht, desto stärker ist sein aggregierter Wert dort. Hervorgehoben sind die Modelle, die unseren endgültigen Cocktail tragen.
General Chat
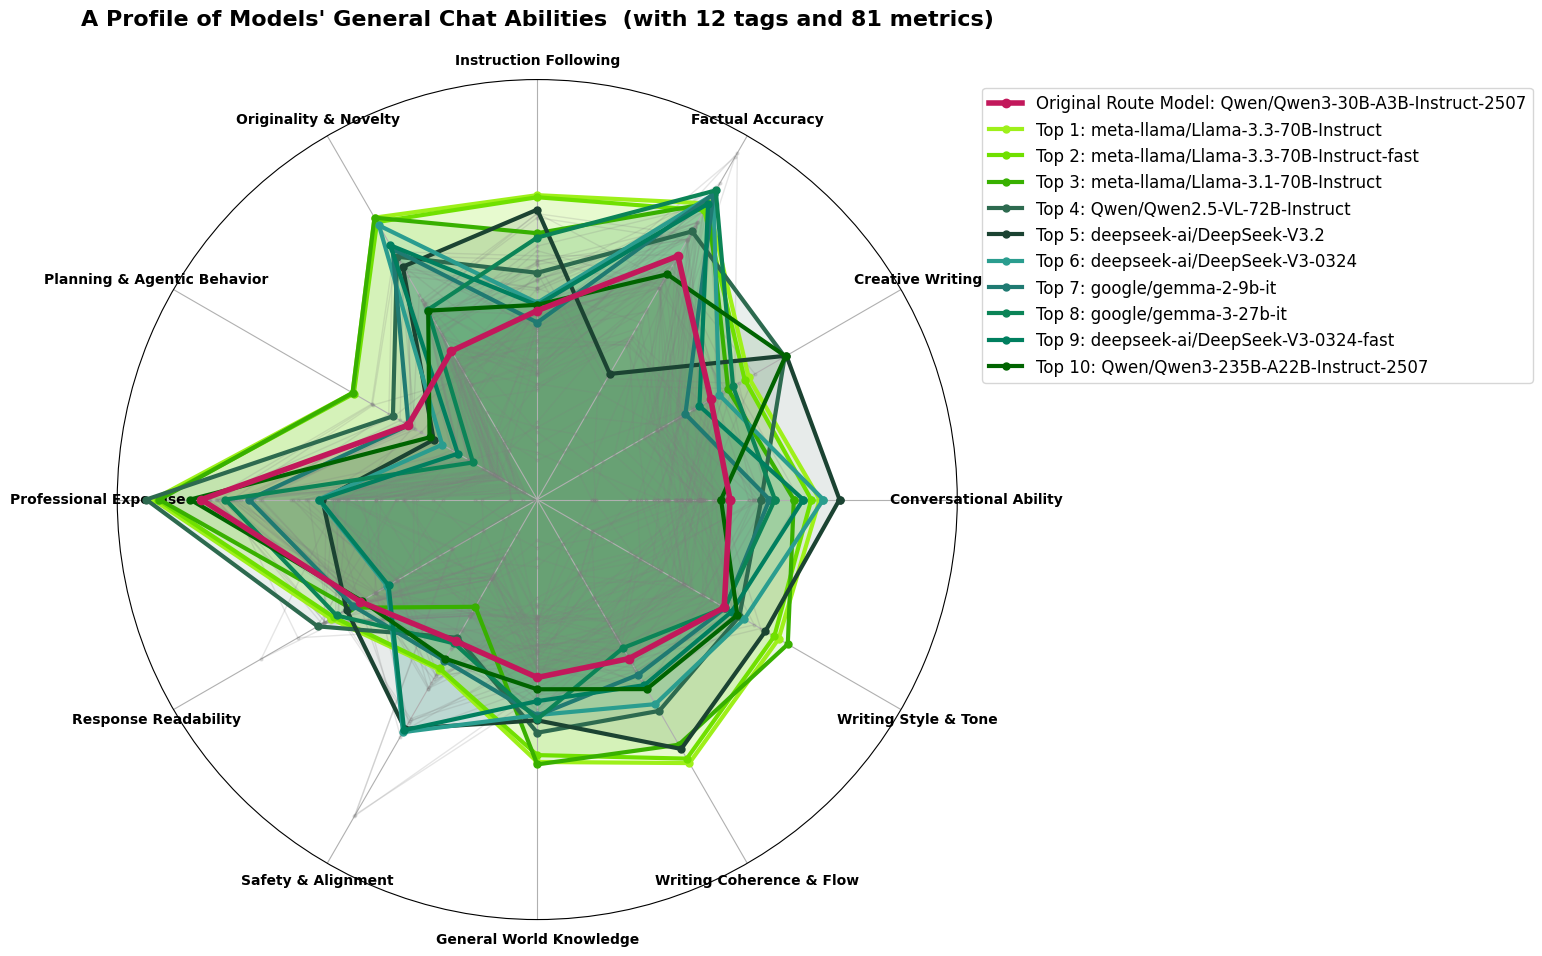
Abbildung 1: Radar für General Chat: Gesprächsfähigkeit, sachliche Genauigkeit, Sicherheitsausrichtung, Stil, Kohärenz und verwandte Dimensionen. Eine größere Fläche bedeutet breitere Abdeckung.
Die Route General Chat vereint Gesprächsfluss, sachliche Genauigkeit, Sicherheit, Befolgen von Anweisungen und grundlegende Schreibqualität. Das Radar in Abbildung 1 zeigt, dass Llama-3.3-70B-Instruct die größte und ausgewogenste Form zeichnet: stark bei Genauigkeit, stark bei Sicherheit, stark bei Kohärenz und ohne größere Schwächen auf einer Achse. Unser bisheriges Rückgrat, ein Qwen-Modell mit 30B, deckt denselben Bereich weniger vollständig ab und steht im ELO-Ranking weiter unten.
Gewähltes Hauptmodell für General Chat: Llama-3.3-70B-Instruct.
Creative Writing
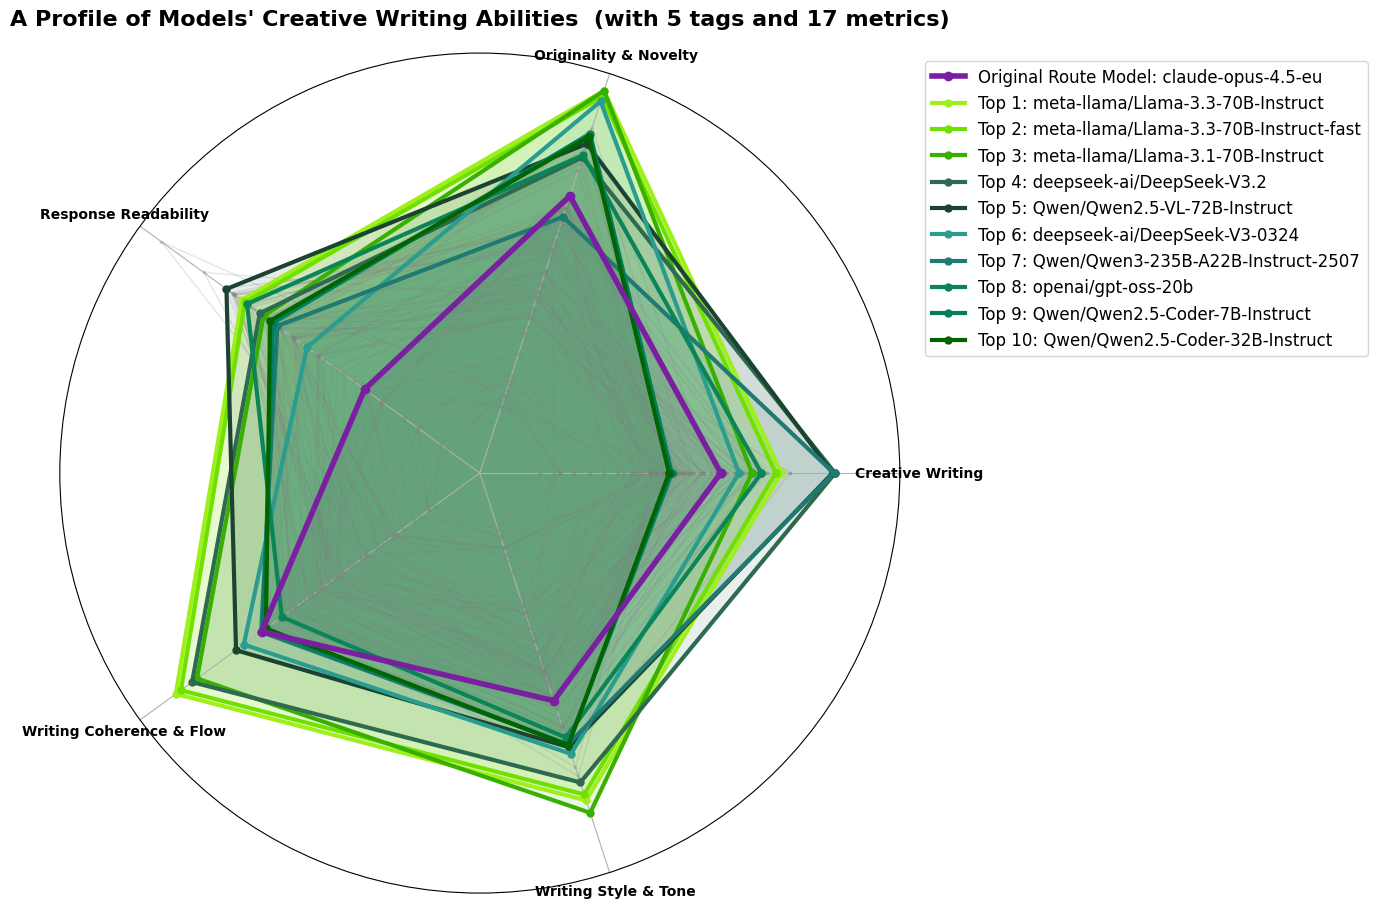
Abbildung 2: Radar für Creative Writing: Originalität, stilistischer Reichtum, Kohärenz, Einhalten von Vorgaben und Lesbarkeit.
Creative Writing belohnt Originalität, stilistische Flexibilität und kohärente lange Texte. Abbildung 2 zeigt, dass sich die Rangliste auf Llama-70B-Modelle und ein neueres Mixture-of-Experts-Modell verteilt, Qwen3-235B-A22B-Instruct-2507. Dieses Qwen3-Modell aktiviert pro Aufruf 22 Milliarden Parameter, greift dabei aber auf einen größeren Pool von Experten zurück. So erreicht es eine große stilistische Bandbreite zu Kosten, die eher einem mittelgroßen dichten Modell entsprechen. Seine Achsen für Originalität und Stil sind besonders stark, während seine Kohärenz mit der Llama-Familie mithalten kann.
Gewähltes Hauptmodell für Creative Writing: Qwen3-235B-A22B-Instruct-2507.
Logic & Science
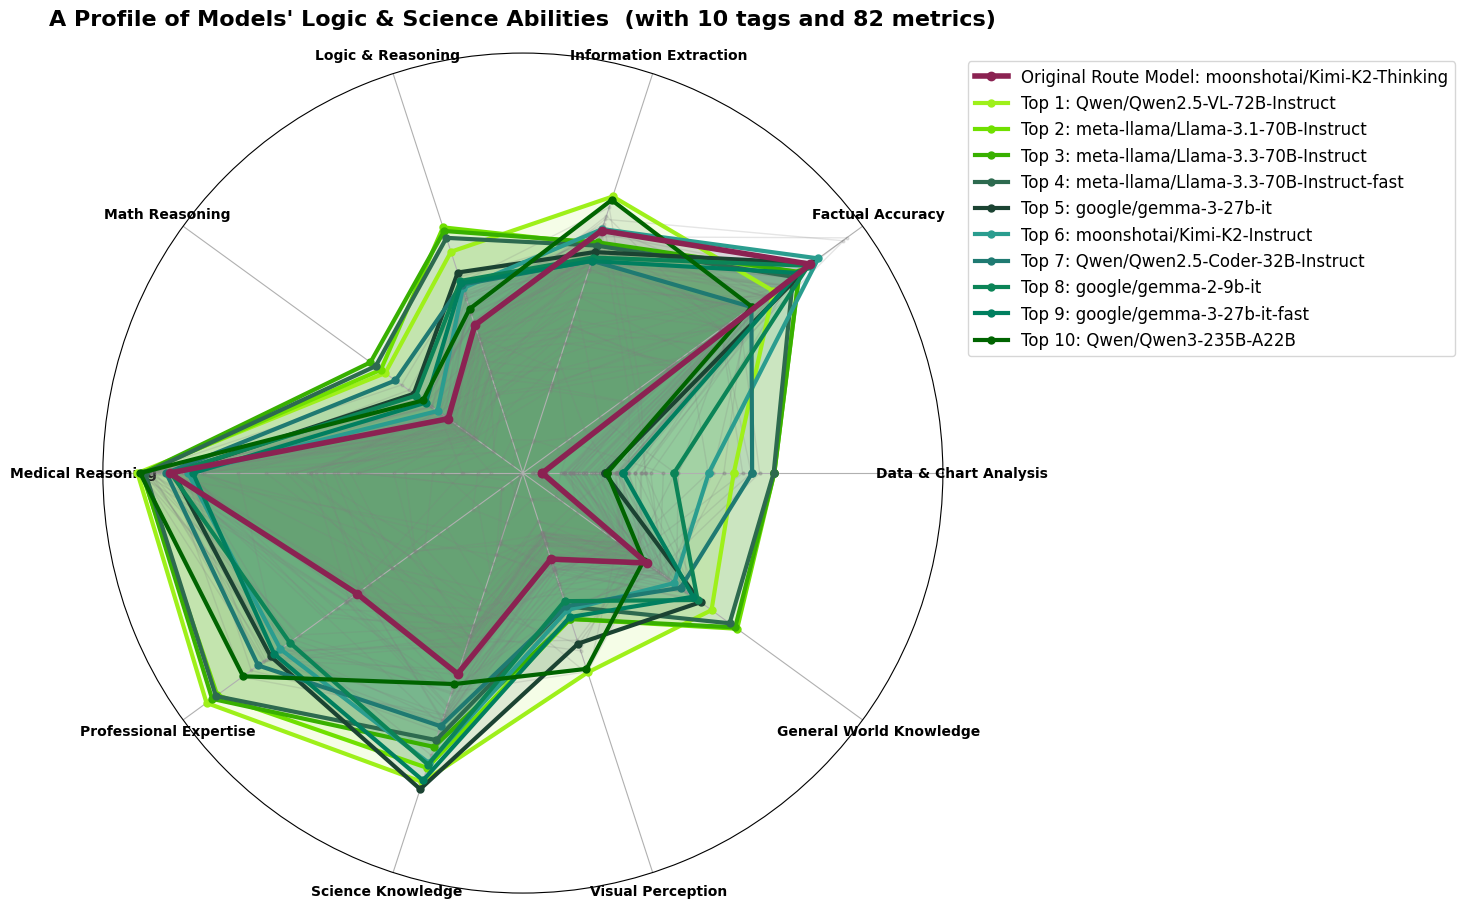
Abbildung 3: Radar für Logic & Science: mathematisches Denken, wissenschaftliches Wissen, Fachexpertise, sachliche Genauigkeit und verwandte Dimensionen über 10 Fähigkeitsachsen und 82 Metriken.
Die Route Logic & Science bearbeitet Mathematik auf Hochschulniveau, MINT-Denken, medizinische Fragen und Anfragen aus Fachgebieten. Das ELO-Ranking führt Llama-3.1 und 3.3-70B an, doch beide sind bereits für General Chat vorgesehen, wo ihre Breite und Sicherheitsausrichtung am wertvollsten sind – dasselbe Modell auf mehreren Routen einzusetzen, widerspricht dem Sinn einer Routing-Architektur. DeepSeek-Varianten sind bei reinen Denkachsen konkurrenzfähig, doch ihre dünne mehrsprachige Abdeckung passt schlecht zu einer Plattform mit europäischem Schwerpunkt, auf der Anfragen auf Deutsch, Französisch, Tschechisch und Portugiesisch alltäglich sind – eine Einschränkung, die wir im nächsten Beitrag ausführlich behandeln.
Damit bleibt Gemma-3-27B-it als stärkster verfügbarer Kandidat: Obwohl es nach Parameterzahl das kleinste Modell unter den ersten fünf ist, zeigt es außergewöhnliche Tiefe bei medizinischem Denken und Fachexpertise – den beiden wichtigsten Achsen dieser Route – und bleibt zugleich bei wissenschaftlichem Wissen und mathematischem Denken konkurrenzfähig.
Gewähltes Hauptmodell für Logic & Science: Gemma-3-27B-it.
Deep Engineering: Der richtige Spezialist aus den richtigen Gründen
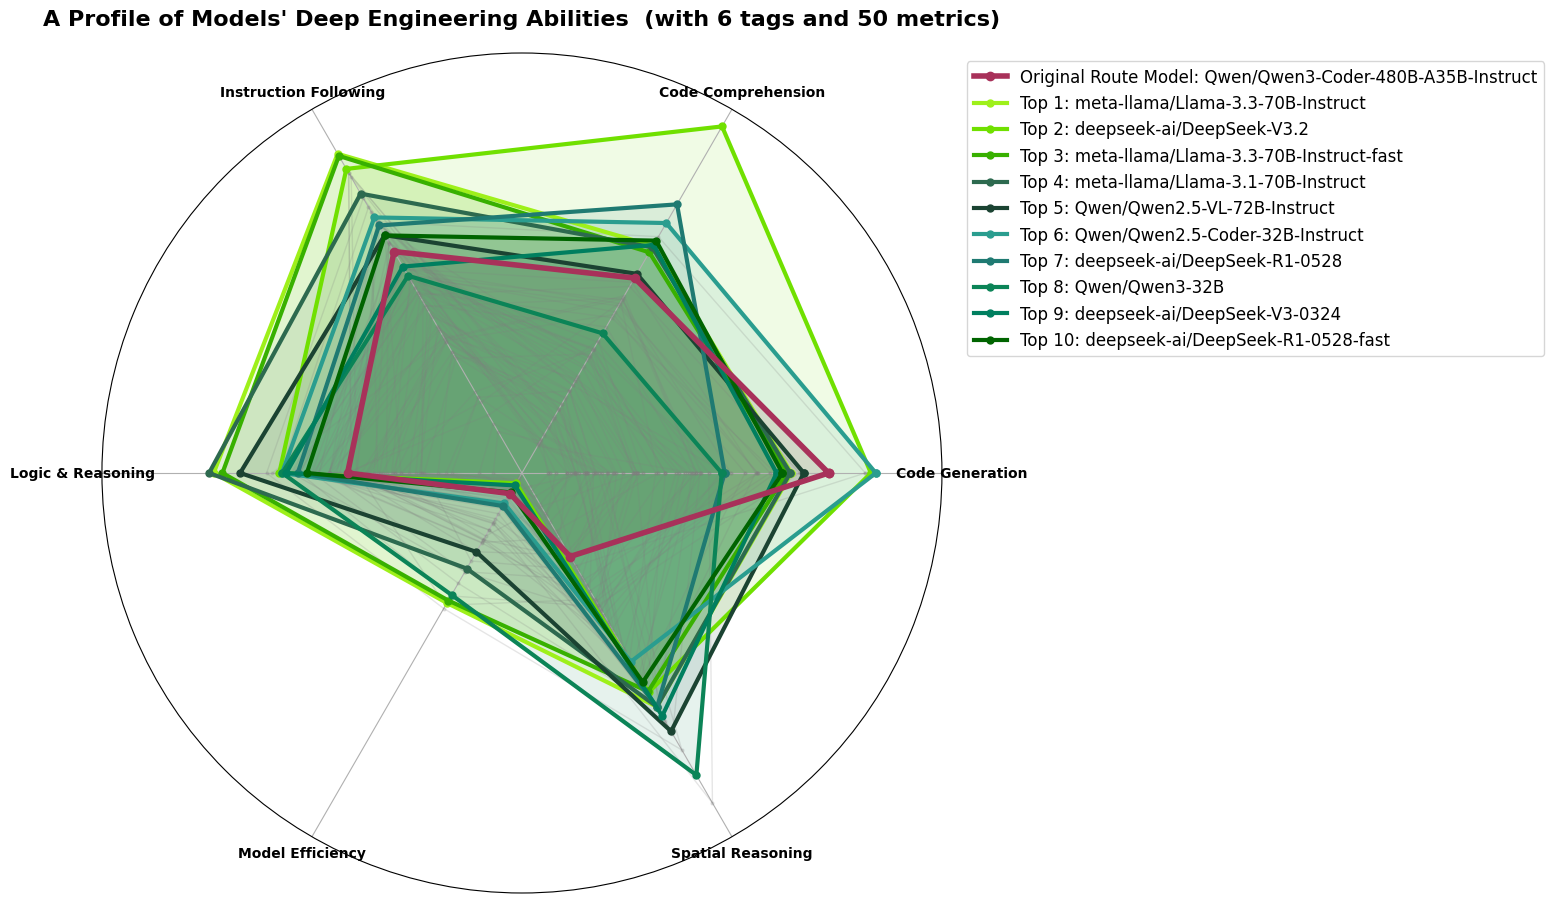
Abbildung 4: Radar für Deep Engineering: Code-Erzeugung, Code-Verständnis, Befolgen von Anweisungen, logisches Denken, räumliches Denken und Modelleffizienz über 6 Fähigkeitsachsen und 50 Metriken.
Die Route Deep Engineering bedient Entwicklerinnen, Entwickler und technische Teams, die präzise Code-Erzeugung, Fehlersuche und Systementwurf brauchen, über sechs Achsen: Code-Erzeugung, Code-Verständnis, Befolgen von Anweisungen, Logik und Schlussfolgern, räumliches Denken und Modelleffizienz. Llama-3.3-70B führt das ELO-Ranking an, ist aber bereits für General Chat vorgesehen; DeepSeek-V3.2 liegt auf Rang 2 mit einem starken Ausschlag bei der Code-Erzeugung, hat aber dieselbe dünne mehrsprachige Abdeckung, die es bei Logic & Science ausgeschlossen hat; und Qwen2.5-VL-72B, das auf Rang fünf mit einem ausgewogenen Radar über alle sechs Achsen liegt, ist für Agents & Tools reserviert, wo seine multimodalen Fähigkeiten unersetzlich sind.
Damit bleibt die Qwen-Coding-Familie als naheliegender Kandidat, und zwar konkret Qwen3-Coder-30B-A3B-Instruct: ein Mixture-of-Experts-Modell, das pro Inferenzschritt nur 3 Milliarden Parameter aktiviert. Sein Fähigkeitsprofil leiten wir zum Teil von seinem gut belegten Geschwister Qwen2.5-Coder ab; die verfügbaren Benchmarks zeigen Code-Qualität auf dem Niveau von Qwen2.5-Coder, bessere Befolgung von Anweisungen durch das Qwen3-Nachtraining und einen Wert für die Modelleffizienz, an den kein dichtes Modell in den Top 10 heranreicht. Das macht es zur kosteneffizientesten und leistungsfähigsten verfügbaren Wahl für produktive Engineering-Abläufe, wobei Qwen2.5-Coder-32B als Zweitmodell mit höherer Kapazität für die anspruchsvollsten Aufgaben bleibt.
Gewähltes Hauptmodell für Deep Engineering: Qwen3-Coder-30B-A3B-Instruct.
Agents & Tools
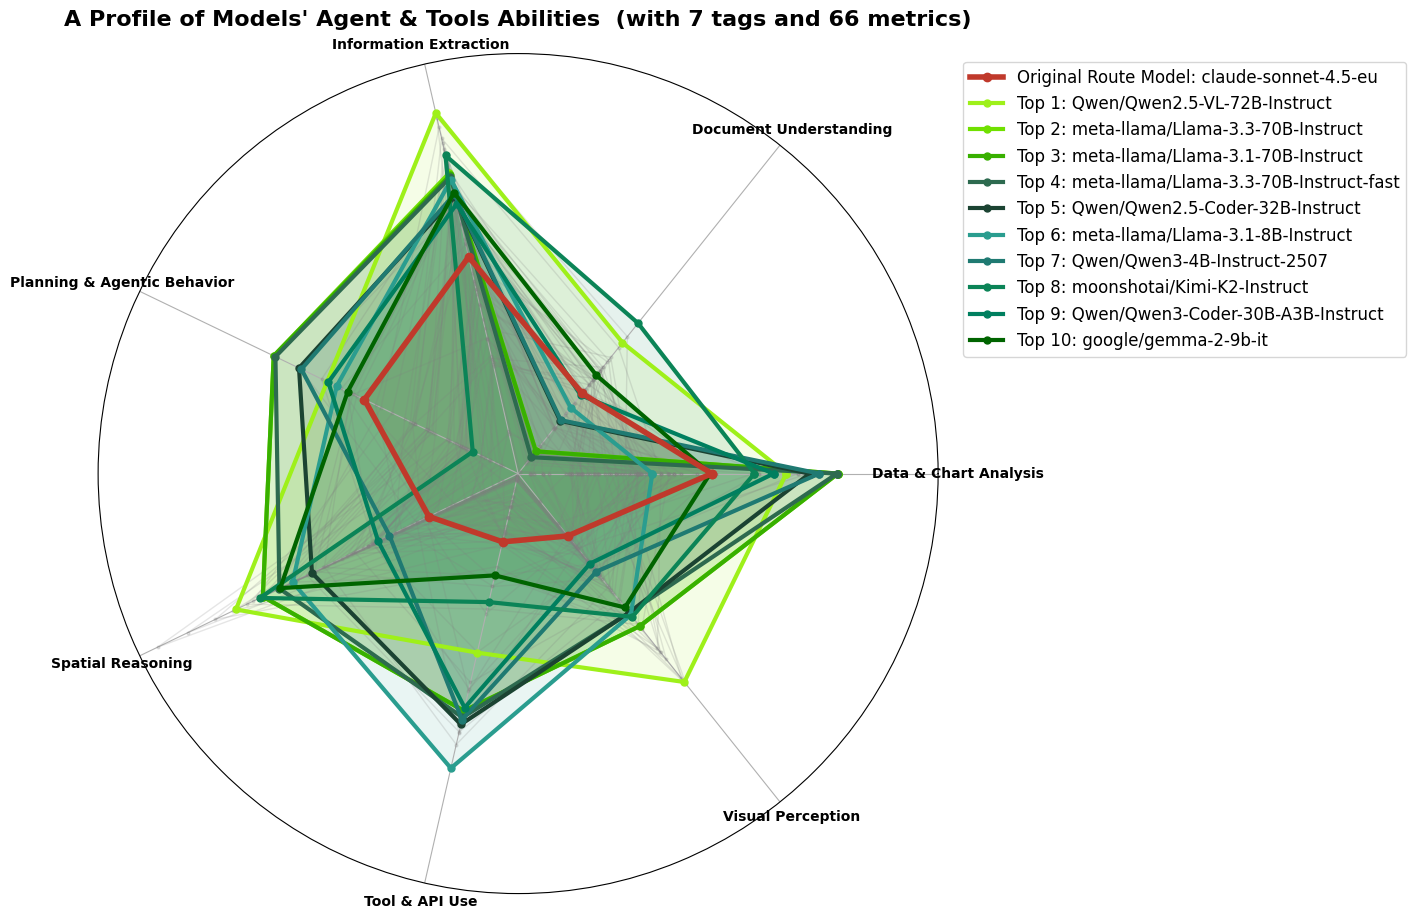
Abbildung 5: Radar für Agents & Tools: Werkzeugplanung, Daten- und Diagrammanalyse, Dokumentverständnis, visuelle Wahrnehmung und räumliches Denken.
Die Route Agents & Tools verlangt Vielseitigkeit und Präzision und braucht Modelle, die komplexe Aufgaben wie mehrstufige Werkzeugaufrufe, das Auswerten von API-Antworten und räumliches Denken beherrschen. Qwen 2.5-VL-72B-Instruct überzeugt in diesen Bereichen und führt die Rangliste mit seinen überlegenen multimodalen Fähigkeiten an.
Agents & Tools ist die komplexeste Route. Sie braucht Modelle, die mehrstufige Werkzeugaufrufe planen, API-Antworten auswerten, Diagramme und Tabellen lesen und über räumliche Anordnungen nachdenken können. Das Radar in Abbildung 5 zeigt Qwen 2.5-VL-72B-Instruct deutlich vorn bei den multimodalen Achsen: Daten- und Diagrammanalyse, visuelle Wahrnehmung und Dokumentverständnis.
Das spiegelt sich in den ELO-Werten wider. Qwen2.5-VL-72B führt das Ranking für Agents & Tools mit großem Abstand an, weil es das einzige Modell ist, das starke Textfähigkeiten mit konkurrenzfähiger Leistung bei multimodalen und Werkzeug-Benchmarks verbindet.
Kleinere Modelle wie Gemma-3-27B-it schneiden bei Dokumentverständnis und Informationsextraktion gut ab, haben aber bei visuellen Aufgaben nicht dieselbe Tiefe. Unser bisheriges Routenmodell, eine Claude-Variante, erscheint in dieser Pipeline deutlich weiter unten, weil öffentliche Benchmarks mit seiner neuesten Generation noch nicht Schritt gehalten haben.
Gewähltes Hauptmodell für Agents & Tools: Qwen2.5-VL-72B-Instruct.
Der endgültige Modell-Cocktail
Zusammengenommen zeigen diese Ergebnisse, dass es kein einzelnes bestes Modell gibt. Dasselbe Llama-Modell, das General Chat dominiert, ist nicht der effizienteste Programmierer. Das Modell, das bei Engineering-Aufgaben vorn liegt, ist nicht das beste beim Lesen von Diagrammen und Dateien. Die Aufgabe des SmartRouters ist es, diese Vielfalt in einen Vorteil zu verwandeln, indem er jede eingehende Anfrage einer Route und jede Route einem gut begründeten Modell zuordnet.
Im Alltag heißt das: aim2balance.ai wählt für die meisten allgemeinen Anfragen still Llama-3.3-70B-Instruct, für kreative Arbeit Qwen3-235B, für wissenschaftliche Fragen Gemma-3-27B-it, für Engineering-Aufgaben Qwen3-Coder-30B und für agentische, werkzeugintensive Abläufe Qwen2.5-VL-72B. Auch wenn du den Router nicht bei seiner Arbeit im Hintergrund siehst, kannst du sicher sein, dass du für jede Anfrage an unser System die besten Modelle bekommst!
Warum Benchmarks weiterhin wichtig sind
Öffentliche Benchmarks sind nicht perfekt. Sie sind lückenhaft, verrauscht und berücksichtigen die allerneuesten Modelle mitunter erst spät. Doch sorgfältig normalisiert, etikettiert und aggregiert liefern sie eine konkrete, nachprüfbare Grundlage für Entscheidungen, die sonst von Hype, Markenbekanntheit oder Einzelfällen bestimmt würden.
Außerdem können wir, sobald neue Benchmarks erscheinen und neue Modelle veröffentlicht werden, die Routen-Rankings neu berechnen und den Cocktail aktualisieren, ohne eine riesige interne Testreihe von Grund auf durchzuführen. So bleibt der SmartRouter auf dem Stand der Technik und hält zugleich unser Umweltbudget ein.


